


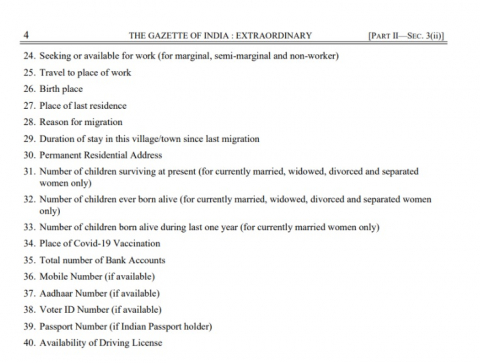
भारत की अगली जनगणना अब सिर्फ इस बात का सवाल नहीं है कि देश में कितने लोग रहते हैं, वे कहां रहते हैं और उनकी सामाजिक-आर्थिक स्थिति क्या है। जनगणना 2027 के जनसंख्या गिनती वाले चरण के लिए प्रश्नावली में परिवारों से व्यक्तिगत और पारिवारिक जानकारी की एक बहुत बड़ी रेंज पूछी गई है। पारंपरिक जनसांख्यिकीय और आर्थिक सवालों के अलावा, डेटा इकट्ठा करने वाले लोग उत्तरदाताओं के माता-पिता, जीवनसाथी, राष्ट्रीयता, स्थायी पते, जाति, डिजिटल साक्षरता, कोविड-19 टीकाकरण, बैंक खातों और पहचान दस्तावेजों (जैसे आधार, वोटर आईडी, पासपोर्ट, ड्राइविंग लाइसेंस और मोबाइल नंबर, जहां उपलब्ध हों) से जुड़ी जानकारी भी दर्ज करेंगे। इस डिटेल ने एक बड़ा सवाल खड़ा कर दिया है कि जनसंख्या जनगणना का असल मकसद क्या होना चाहिए और ऐसी प्रक्रिया की सीमाएँ कहां तक होनी चाहिए।
इस व्यापक कार्यप्रणाली पर गंभीर आपत्तियां उठाई गई हैं। साफ तौर पर इसका मकसद नीतिगत दिशा तय करने के लिए भारतीय लोगों की सामाजिक-आर्थिक गिनती से कहीं ज्यादा जानकारी हासिल करना है (और यह मकसद परोक्ष रूप से हासिल किया जा रहा है), फिर भी केंद्र सरकार ने यही रास्ता चुना है। नागरिकता अधिनियम, 1955 में 2019 के विवादास्पद संशोधनों के बाद ऐसी कोशिशों का विश्लेषण यहां, यहां और यहां किया गया है।
भारतीय रजिस्ट्रार जनरल एवं जनगणना आयुक्त ने 14 अगस्त, 2026 को जनसंख्या गिनती के चरण के लिए 40 सवालों की अधिसूचना जारी की। 2011 की जनगणना की तुलना में इस प्रश्नावली में कई नए या बदले हुए सवाल शामिल हैं। यह प्रक्रिया इसलिए भी महत्वपूर्ण है क्योंकि स्वतंत्रता के बाद पहली बार जनसंख्या जनगणना में अनुसूचित जाति और अनुसूचित जनजाति श्रेणियों के अलावा अन्य जातियों को भी शामिल किया जा रहा है।
इस संयोजन ने जनगणना 2027 को बेहद महत्वपूर्ण बना दिया है, लेकिन साथ ही यह प्रक्रिया कार्यप्रणाली, गोपनीयता, जानकारी की सुरक्षा और इकट्ठा की गई जानकारी के अंतिम इस्तेमाल को लेकर भी सवालों के घेरे में है।

‘द हिंदू’ की 9 सितंबर की रिपोर्ट के अनुसार, भारत के पूर्व डिप्टी रजिस्ट्रार जनरल के. नारायणन उन्नी ने सवाल उठाया कि क्या नए शामिल किए गए कई सवालों से कोई सार्थक सांख्यिकीय जानकारी मिल पाएगी। उनकी चिंता सिर्फ़ इकट्ठा की जा रही जानकारी की मात्रा को लेकर नहीं थी, बल्कि इस बात को लेकर थी कि व्यक्तिगत पहचान और पारिवारिक विवरण मांगने से कहीं जनगणना अपने पारंपरिक सांख्यिकीय मकसद से भटक न जाए। जनगणना का मकसद आबादी की गिनती करना होता है, न कि पहचान का कोई रिकॉर्ड बनाना।
जनगणना का अहम मकसद आबादी की गिनती करना और उसकी सामाजिक-आर्थिक स्थिति को समझना होता है। संयुक्त राष्ट्र के अनुसार, जनगणना एक देश में एक खास समय पर सभी लोगों से जुड़ी जनसांख्यिकीय, आर्थिक और सामाजिक जानकारी इकट्ठा करने, प्रोसेस करने, उसका विश्लेषण करने और उसे जारी करने की एक व्यापक प्रक्रिया है। इसका मकसद सबसे छोटे भौगोलिक स्तर पर भरोसेमंद आंकड़े तैयार करना है ताकि सरकारें और समाज आबादी के पैटर्न को समझ सकें और ऐसी नीतियां लागू कर सकें जो उस आबादी के काम आएं। यह अंतर इसलिए अहम है क्योंकि व्यक्तिगत पहचान वाली जानकारी आमतौर पर उस सांख्यिकीय जानकारी का हिस्सा नहीं होती जिसे जनगणना के बाद प्रकाशित किया जाता है।
संयुक्त राष्ट्र के आधिकारिक आंकड़ों के बुनियादी सिद्धांत भी आधिकारिक डेटा इकट्ठा करने में गोपनीयता को अहमियत देते हैं। सांख्यिकीय एजेंसियों द्वारा इकट्ठा की गई व्यक्तिगत जानकारी गोपनीय रहनी चाहिए और उसका इस्तेमाल सिर्फ नीति बनाने के मकसद से ही किया जाना चाहिए।
भारत का जनगणना ढांचा ऐतिहासिक रूप से इस सिद्धांत को मानता रहा है। जनगणना अधिनियम, 1948 की धारा 15 जनगणना रिकॉर्ड को जांच-पड़ताल से बचाती है और यह प्रावधान करती है कि ऐसे रिकॉर्ड न तो जांच के लिए खुले हैं और न ही उन्हें सबूत के तौर पर पेश किया जा सकता है।
अब सवाल यह है कि क्या बड़ा किया गया प्रश्नावली (questionnaire) इकट्ठा की जा रही जानकारी के स्वरूप को बदल देता है, बिना यह स्पष्ट किए कि वह जानकारी अन्य सरकारी डेटाबेस और प्रशासनिक उद्देश्यों से कैसे अलग रखी जाएगी।
चिंता इसलिए भी ज्यादा है क्योंकि प्रश्नावली में सिर्फ यह नहीं पूछा जाता कि एक घर में कितने लोग रहते हैं या उनका पेशा, शिक्षा या प्रवास की स्थिति क्या है। इसमें ऐसी जानकारी मांगी जाती है जिससे सीधे तौर पर व्यक्तियों की पहचान की जा सके और उन्हें मौजूदा प्रशासनिक डेटाबेस से जोड़ा जा सके।
आधार नंबर UIDAI रिकॉर्ड से जुड़े होते हैं। वोटर पहचान नंबर मतदाता सूची से जुड़े होते हैं। पासपोर्ट नंबर पासपोर्ट रिकॉर्ड से जुड़े होते हैं। मोबाइल नंबर टेलीकम्युनिकेशन रिकॉर्ड से जुड़े होते हैं। बैंक की जानकारी वित्तीय प्रणाली में मौजूद होती है। इसलिए, घर-स्तर की एक ही कवायद में ऐसी जानकारी इकट्ठा करना, नीति-सांख्यिकीय सारणीकरण के लिए गुमनाम जनसांख्यिकीय जानकारी इकट्ठा करने से बुनियादी तौर पर अलग है।
माता-पिता की जानकारी क्यों मांगी जा रही है?
सबसे खास नई चीजों में से एक है हर व्यक्ति के माता-पिता के बारे में सवाल। प्रश्नावली में माता-पिता के बारे में जानकारी मांगी गई है, जिसमें उनके नाम, धर्म और जन्म-स्थान जैसी बातें शामिल हैं। यह जानकारी गांव के स्तर तक भी हो सकती है। शादीशुदा लोगों के मामले में जीवनसाथी के बारे में भी पूछा जाता है। इन सवालों से व्यावहारिक चिंताएं और इनके मकसद को लेकर सवाल उठते हैं।
एक आम घर में, जनगणना का जवाब देने वाले व्यक्ति को शायद अपने माता-पिता या दादा-दादी के जन्म-स्थान की सही जानकारी न हो। हॉस्टल, वृद्धाश्रम और जेल जैसे संस्थागत घरों में यह समस्या और भी जटिल हो जाती है। भारत में लोगों के एक जगह से दूसरी जगह जाकर बसने (माइग्रेशन) के बदलते स्वरूप से यह मामला और भी पेचीदा हो जाता है। लाखों छात्र, कामगार और अन्य निवासी अपने स्थायी घरों से दूर रहते हैं। बच्चे हॉस्टल में या पेइंग गेस्ट के तौर पर रह सकते हैं। घरेलू कामगार और अन्य लोग जनगणना के समय परिवारों के साथ अस्थायी रूप से रह सकते हैं।
यह उम्मीद नहीं की जा सकती कि जवाब देने वाले व्यक्ति को उस जगह पर जनगणना के लिए पात्र हर व्यक्ति की पहचान-दस्तावेज की जानकारी, माता-पिता की जानकारी या अन्य व्यक्तिगत विवरण पता हों। प्रश्नावली जितनी ज्यादा जानकारी मांगती है, उतनी ही ज्यादा संभावना होती है कि जवाब देने वाले या तो सही जवाब नहीं दे पाएंगे या फिर जल्दबाजी में या अधूरे जवाब देंगे। जनगणना के पूर्व अधिकारियों ने इसे “जवाब देने वाले की थकान” (respondent fatigue) की समस्या बताया है।
आधार, वोटर आईडी, पासपोर्ट और मोबाइल नंबर
पहचान नंबर शामिल करने से एक अलग समस्या पैदा होती है। प्रश्नावली में मोबाइल नंबर, आधार नंबर और वोटर आईडी नंबर “यदि उपलब्ध हो” तो मांगे जाते हैं, साथ ही भारतीय पासपोर्ट धारकों के लिए पासपोर्ट की जानकारी और ड्राइविंग लाइसेंस की उपलब्धता के बारे में भी पूछा जाता है। लेकिन “यदि उपलब्ध हो” का असल में क्या मतलब है?
जैसा कि ‘द हिंदू’ ने रिपोर्ट किया, यह स्पष्ट नहीं है कि इस वाक्यांश का मतलब यह है कि अगर संबंधित व्यक्ति के पास नंबर है तो उसे दिया जाना चाहिए, या इसका मतलब यह है कि अगर जनगणना के समय जवाब देने वाले के पास वह नंबर है तो उसे दिखाया जाना चाहिए। बड़े परिवारों में यह अंतर महत्वपूर्ण हो सकता है। जनगणना का जवाब देने वाले व्यक्ति के पास परिवार के हर सदस्य का आधार, वोटर आईडी या पासपोर्ट विवरण नहीं हो सकता है। बुजुर्ग माता-पिता, घरेलू कामगारों, मेहमानों और संस्थागत आवासों में अस्थायी रूप से रहने वाले लोगों के पास उनके दस्तावेज तुरंत उपलब्ध नहीं हो सकते हैं। एक और बुनियादी सवाल यह है कि असल पहचान नंबर को रिकॉर्ड करने से कौन-सा सांख्यिकीय मकसद पूरा होता है?
जैसा कि IIPS के पूर्व डायरेक्टर के.एस. जेम्स ने ‘द वायर’ को बताया, व्यक्तिगत पहचानकर्ता जनगणना के आंकड़ों को व्यवस्थित करने के लिए सीधे तौर पर उपयोगी नहीं होते हैं, क्योंकि उन्हें पारंपरिक जनसंख्या आंकड़ों में सार्थक रूप से शामिल नहीं किया जा सकता है। उनकी नजर में, ऐसे पहचानकर्ता पहचान या जनसंख्या-पंजीकरण की प्रक्रिया का हिस्सा ज्यादा लगते हैं।
NPR का सवाल
सबसे ज्यादा राजनीतिक रूप से संवेदनशील मुद्दा जनगणना के कई सवालों और उस जानकारी के बीच ओवरलैप (मेल) है जो पहले नेशनल पॉपुलेशन रजिस्टर (NPR) के लिए मांगी गई थी। ‘द इंडियन एक्सप्रेस’ ने 2020 के NPR शेड्यूल के साथ ओवरलैप करने वाले आठ नए या बदले हुए फील्ड की पहचान की है, जिनमें बताई गई राष्ट्रीयता, माता-पिता की जानकारी, मोबाइल नंबर, आधार, वोटर ID, पासपोर्ट और ड्राइविंग लाइसेंस शामिल हैं।
नेशनल पॉपुलेशन रजिस्टर सिर्फ नागरिकों का रजिस्टर नहीं, बल्कि “आम निवासियों” का रजिस्टर है। इसके नियमों के तहत, आम निवासी का मतलब मोटे तौर पर ऐसे व्यक्ति से है जो किसी इलाके में कम से कम छह महीने से रह रहा हो या वहां कम से कम छह महीने रहने का इरादा रखता हो। इसलिए, जो विदेशी नागरिक रहने की इस शर्त को पूरा करता है, वह NPR के दायरे में आ सकता है।
‘सिटिजन्स फॉर जस्टिस एंड पीस’ (cjp.org.in) की टीम ने 2020 में इस मुद्दे पर काफी रिसर्च की थी और यहां एक डॉक्यूमेंट है जो NPR और जनगणना के बीच के अंतर को समझने में मदद करता है, जो आज भी प्रासंगिक है। इसे यहां पढ़ा जा सकता है।
कानूनी ढांचा पॉपुलेशन रजिस्टर को ‘भारतीय नागरिकों के राष्ट्रीय रजिस्टर’ (National Register of Indian Citizens) को तैयार करने से भी जोड़ता है। नागरिकता (नागरिकों का पंजीकरण और राष्ट्रीय पहचान पत्र जारी करना) नियम, 2003 में नागरिकों के रजिस्टर को तैयार करने के सिलसिले में पॉपुलेशन रजिस्टर के सत्यापन का प्रावधान है, जिसमें उन मामलों को चिह्नित करने की संभावना भी शामिल है जिनमें नागरिकता संदिग्ध मानी जाती है और आगे जांच की जरूरत होती है।
यह कानूनी ढांचा तब खास तौर पर विवादित हो गया जब सरकार ने 2019-20 में जनगणना प्रक्रिया के साथ-साथ NPR को अपडेट करने का प्रस्ताव रखा। यह प्रस्ताव नागरिकता संशोधन अधिनियम (CAA) के पास होने के ठीक बाद और CAA-NPR-NRC ढांचे के खिलाफ देशव्यापी विरोध प्रदर्शनों के बीच आया था। राजनीतिक संदर्भ अभी भी बना हुआ है।
‘इंडियन एक्सप्रेस’ की रिपोर्ट के अनुसार, माता-पिता के जन्म स्थान और जन्म तिथि से जुड़े सवाल पिछली NPR प्रक्रिया के सबसे विवादित हिस्सों में से थे। उस समय सरकार का कहना था कि ऐसी जानकारी देना वैकल्पिक है और सिर्फ इसलिए किसी की नागरिकता नहीं जाएगी कि वे अपने माता-पिता के जन्म का विवरण नहीं दे पाए। सरकार ने यह भी तर्क दिया कि NPR का मकसद निवासियों का एक व्यापक डेटाबेस बनाना था, जो नीति बनाने, कल्याणकारी योजनाओं को लागू करने और प्रशासनिक दक्षता में मदद कर सके। इसलिए, मौजूदा विवाद सिर्फ दो प्रश्नावली (questionnaires) की समानता पर आधारित नहीं है। यह इस बात से भी तय होता है कि NPR को कैसे समझा गया और उसका विरोध कैसे हुआ।
सरकार का रुख और भरोसे की कमी
शिक्षा, आवास, परिवहन और स्वास्थ्य पर नीतियां बनाने में सरकारों की मदद के लिए नियमित रूप से व्यापक जनगणना (सामाजिक-आर्थिक जनसंख्या डेटाबेस) की आवश्यकता होती है: इसके आधार पर स्कूलों, अस्पतालों, आवास, परिवहन, कल्याणकारी कार्यक्रमों और अन्य सार्वजनिक सेवाओं की योजना बनाई जा सकती है।
हालांकि, अभी चल रही प्रक्रिया, जिसमें उस सीमित मकसद से परे सवाल शामिल हैं, ने मकसद और इस्तेमाल (एप्लीकेशन), दोनों पर सवाल खड़े कर दिए हैं। क्या इकट्ठा किए गए डेटा का इस्तेमाल सिर्फ़ उसी मकसद के लिए किया जाएगा जिसके लिए इसे तय किया गया था? यानी लोगों की सामाजिक-आर्थिक जरूरतों को पूरा करने वाली नीतियां बनाने के लिए?
जैसा कि ‘इंडियन एक्सप्रेस’ ने बताया है, 2019 और 2020 में सरकार के आश्वासनों के साथ-साथ पिछले आधिकारिक बयान और नागरिकता नियम भी मौजूद थे, जिन्होंने जनसंख्या रजिस्टर और नागरिकों का रजिस्टर तैयार करने की प्रक्रिया के बीच कानूनी संबंध स्थापित किया था। असम में NRC, जिसमें लगभग 19 लाख लोगों को बाहर कर दिया गया था, ने नागरिकता सत्यापन के नतीजों के बारे में चिंताओं को और बढ़ा दिया। नतीजतन, राष्ट्रीयता, माता-पिता के जन्म स्थान और पहचान दस्तावेजों के बारे में सवाल किसी राजनीतिक शून्य में नहीं उठ रहे हैं।
जानकारी मांगने का कोई ऐसा अनुरोध जो प्रशासनिक रूप से सामान्य लग सकता है, नागरिकता, प्रवासन और NPR-NRC ढांचे पर पिछली बहस की पृष्ठभूमि में पेश किए जाने पर बहुत अलग मायने रख सकता है। इसीलिए मुख्य मुद्दा सिर्फ यह नहीं है कि सरकार को कोई खास सवाल पूछने का कानूनी अधिकार है या नहीं। बल्कि यह भी है कि क्या नागरिक साफ तौर पर समझ सकते हैं कि जानकारी क्यों इकट्ठा की जा रही है, इसका इस्तेमाल किसलिए होगा, इसे कौन देख सकेगा, इसे कितने समय तक रखा जाएगा और क्या बाद में इसे किसी दूसरे सरकारी डेटाबेस से जोड़ा जा सकता है।
1951 का उदाहरण
जनगणना के पूर्व अधिकारियों ने इतिहास की ओर भी इशारा किया है। 10 सितंबर की एक रिपोर्ट में, ‘द हिंदू’ ने बताया कि 1951 की जनगणना के रिकॉर्ड से पता चलता है कि उस समय नेशनल रजिस्टर ऑफ सिटिजन्स (NRC) तैयार करने में जनगणना की जानकारी का इस्तेमाल किया गया था। असम, मणिपुर और त्रिपुरा के लिए जनगणना कार्यों के तत्कालीन अधीक्षक आर.बी. वाघईवाला की 1951 की जनगणना रिपोर्ट में बताया गया था कि NRC को जनगणना पर्चियों से जरूरी डेटा उतारकर तैयार किया गया था। रिपोर्ट में कहा गया था कि रजिस्टर असल में जनगणना पर्चियों की ही एक कॉपी थी, जिसमें वही निशान और शॉर्ट-फॉर्म इस्तेमाल किए गए थे। हालांकि, जिस बात को नजरअंदाज किया जा रहा है या छोड़ दिया जा रहा है, वह यह है कि 1951 की जनगणना के सवाल जवाब देने वाले नागरिकों की सामाजिक-आर्थिक स्थिति से जुड़े थे, और कुछ नहीं। विडंबना यह है कि इसी पहलू का इस्तेमाल असम में सतर्क नौकरशाही ने 1951 के NRC में नाम होने को नागरिकता का पर्याप्त सबूत न मानने के तर्क के तौर पर किया है!
इसी पृष्ठभूमि के कारण 2026 की जनगणना में डेटा इकट्ठा करने में स्पष्टता और गोपनीयता की जरूरत और भी अहम हो जाती है।
जाति जनगणना: ऐतिहासिक मौका, अनसुलझा तरीका
2027 की जनगणना की एक और अहम विशेषता जाति की गिनती है। भारत ने 1931 के बाद से पूरी जाति जनगणना नहीं कराई है। इसलिए, 2027 की जनगणना से ऐसा डेटा मिलेगा जो सामाजिक और आर्थिक असमानताओं को समझने के लिए बहुत अहम हो सकता है। लेकिन इसके तरीके को लेकर ही विवाद खड़ा हो गया है।
सवालों की इस सूची (क्वेश्चनेयर) में लोगों से उनकी जाति बताने को कहा गया है, लेकिन एक स्टैंडर्ड लिस्ट-आधारित सिस्टम के उलट, SC और ST कैटेगरी के अलावा दूसरी जातियों के लिए यह फील्ड काफी हद तक ओपन-एंडेड (खुला) है। समस्या सिर्फ तकनीकी नहीं है। 2011 की सामाजिक-आर्थिक और जाति जनगणना के अनुभव से बिना स्टैंडर्ड वाले तरीके के नतीजे सामने आए। उस प्रक्रिया में 46 लाख से ज्यादा जाति के नाम सामने आए, जिनमें जातियों, उप-जातियों, गोत्रों और उपनामों के अलग-अलग रूप शामिल थे। बाद में केंद्र सरकार ने सुप्रीम कोर्ट को बताया कि कच्चे जाति डेटा में तकनीकी समस्याएं थीं और उसे जारी नहीं किया गया था। इसलिए, सरकार द्वारा सुप्रीम कोर्ट में पहले दी गई जानकारी मौजूदा बहस के लिए अहम हो गई है।
2021 में, केंद्र ने तर्क दिया था कि जाति की गिनती, खासकर OBC की, प्रशासनिक रूप से जटिल थी और मौजूदा डेटा में पूर्णता और सटीकता की गंभीर समस्याएं थीं। फिर भी, ‘द इंडियन एक्सप्रेस’ और ‘द हिंदू’ में बताए गए विशेषज्ञों ने सवाल उठाया है कि 2011 की प्रक्रिया से मिले सबक को 2027 की कार्यप्रणाली में क्यों शामिल नहीं किया गया। IIPS के पूर्व डायरेक्टर के.एस. जेम्स ने सुझाव दिया कि एक ऐसा सिस्टम जिसमें राज्य और केंद्र की मान्यता प्राप्त जाति सूचियों को मिलाया जाए और लोगों को अतिरिक्त जानकारी देने का विकल्प भी हो, उससे डेटा को ज्यादा उपयोगी बनाया जा सकता है।
समाजशास्त्री सतीश देशपांडे ने इससे आगे बढ़कर तर्क दिया कि ओपन-एंडेड सिस्टम में स्पेलिंग के अलग-अलग रूपों और जाति के नामों की भरमार होने का जोखिम है, जिससे मिलने वाले डेटा का विश्लेषण करना मुश्किल हो सकता है। विशेषज्ञों की ये राय एक गंभीर कार्यप्रणाली संबंधी सवाल उठाती है: अगर जाति डेटा इसलिए इकट्ठा किया जा रहा है क्योंकि इससे सार्वजनिक नीति, सकारात्मक कार्रवाई और सामाजिक न्याय के उपायों में मदद मिलने की उम्मीद है, तो डेटा इकट्ठा करने का तरीका ऐसा होना चाहिए जिससे ऐसा डेटा मिल सके जिसे असल में वर्गीकृत और विश्लेषित किया जा सके।
OBC का सवाल
एक और अनसुलझा मुद्दा ‘अन्य पिछड़ा वर्ग’ (OBC) से जुड़ा है। सवाल-जवाब वाली सूची में अनुसूचित जाति, अनुसूचित जनजाति और जाति के फ़ील्ड शामिल हैं, लेकिन इसमें OBC को उस तरह से अलग कैटेगरी के तौर पर नहीं दिखाया गया है जैसा आलोचकों को उम्मीद थी।
इसके बाद कांग्रेस नेताओं मल्लिकार्जुन खड़गे और राहुल गांधी ने प्रधानमंत्री नरेंद्र मोदी को पत्र लिखकर सवालों वाली सूची में बदलाव की मांग की और तर्क दिया कि इस कार्यप्रणाली से जाति डेटा की सटीकता और उपयोगिता कम हो सकती है। कांग्रेस नेता जयराम रमेश ने भी पहले से तैयार जाति सूची न होने की आलोचना की है और इसकी तुलना बिहार और तेलंगाना में हुए जाति सर्वेक्षणों के तरीके से की है।
ये राजनीतिक दावे हैं और इन्हें उसी तरह समझा जाना चाहिए। हालांकि, इसके पीछे के तरीके से जुड़ा सवाल अलग से परखा जा सकता है: क्या बिना सही मानकीकरण (standardisation) के जाति के लिए खुला विकल्प (open-ended field) रखने से भरोसेमंद, तुलना करने लायक और नीति बनाने में काम आने वाला डेटा मिलेगा?
यह सवाल इसलिए भी अहम है क्योंकि जाति के आंकड़े सिर्फ किताबी या शैक्षणिक आंकड़े नहीं होते। ये कल्याणकारी योजनाओं, आरक्षण नीतियों, शिक्षा से जुड़े कदमों और ढांचागत असमानता को दूर करने के लिए उठाए गए अन्य उपायों की रूपरेखा को प्रभावित कर सकते हैं।
एक ऐसा सवालनामा जो इतना लंबा हो सकता है कि सटीक जानकारी न मिल पाए
एक और समस्या है जो राजनीतिक रूप से उतनी बड़ी नहीं लगती, लेकिन अहम है: समय। जनसंख्या की गिनती की सूची में 40 सवाल होते हैं, जिनमें से कई का जवाब घर के हर सदस्य के लिए देना होता है। माता-पिता, जीवनसाथी, पहचान के दस्तावेज, बैंक खाते, टीकाकरण का इतिहास और अन्य व्यक्तिगत जानकारी से जुड़े सवाल जोड़ने पर जानकारी की मात्रा बढ़ जाती है, जिसे डेटा इकट्ठा करने वालों (एन्यूमरेटर) को इकट्ठा और दर्ज करना होता है।
जनगणना के पूर्व अधिकारियों ने ‘द हिंदू’ को बताया कि इससे जानकारी देने वाले लोग थक सकते हैं, खासकर तब जब एन्यूमरेटर को घर के कई सदस्यों के साथ लंबे सवालों की सूची पर काम करना पड़ता है। इसका बोझ एन्यूमरेटर पर ज्यादा पड़ेगा, जिनमें से कई सरकारी स्कूल के शिक्षक हैं।
अगर सवालों की सूची पूरा करने में काफी ज्यादा समय लगता है, तो इसके नतीजे सिर्फ असुविधा तक सीमित नहीं रहते। थकान से सटीकता पर असर पड़ सकता है। जानकारी देने वाले लोग बेसब्र हो सकते हैं। एन्यूमरेटर जल्दबाजी कर सकते हैं। सवालों को गलत समझा जा सकता है। जवाब अंदाज़े से दिए जा सकते हैं या अधूरे छोड़े जा सकते हैं। इसलिए, बहुत ज्यादा जानकारी इकट्ठा करने की कोशिश में जनगणना अपने ही सांख्यिकीय लक्ष्यों को कमजोंर कर सकती है। यह मुद्दा भारत जैसे बड़े और विविधता वाले देश में खास तौर पर अहम है, जहां जनसंख्या डेटा की विश्वसनीयता करोड़ों लोगों की एक जैसी गिनती पर निर्भर करती है।
माइग्रेशन (प्रवास) से एक और जोखिम पैदा होता है
उत्तर प्रदेश, पंजाब, उत्तराखंड और गोवा में होने वाले चुनावों के कारण जनसंख्या की गिनती (जनगणना) को पहले करने के फैसले ने एक और चिंता पैदा कर दी है: प्रवासियों की गिनती कम होना। जैसा कि ‘द हिंदू’ ने रिपोर्ट किया, जनगणना के पूर्व अधिकारी के. नारायणन उन्नी ने चेतावनी दी कि इन राज्यों में जल्दी गिनती करने से उन प्रवासी श्रमिकों पर असर पड़ सकता है जो अपने काम की जगह और अपने गृह राज्य के बीच आते-जाते रहते हैं।
भारत में गिनती का ‘डी-फैक्टो’ (वास्तविक स्थिति पर आधारित) तरीका अपनाया जाता है, जिसके तहत लोगों की गिनती आम तौर पर वहीं की जाती है जहां वे जनगणना की अवधि के दौरान शारीरिक रूप से मौजूद होते हैं। पारंपरिक रूप से, 1 मार्च को संदर्भ तिथि (रेफरेंस डेट) के रूप में इस्तेमाल किया जाता रहा है, जिसका एक कारण यह है कि उस समय प्रवास का स्तर अपेक्षाकृत कम होता है।
अगर चुनावों के कारण कुछ राज्यों में गिनती जल्दी की जाती है, तो प्रवासी श्रमिक वोट देने के लिए अपने गृह राज्य लौट सकते हैं और हो सकता है कि वे अपनी काम की जगह पर गिनती में शामिल न हो पाएं। अगर गृह राज्य में गिनती पहले ही पूरी हो चुकी है, तो ऐसी संभावना है कि कुछ प्रवासी दोनों ही जगहों पर गिनती से छूट जाएं। यह केवल प्रशासनिक असुविधा का मामला नहीं, बल्कि डेटा की गुणवत्ता से जुड़ी समस्या है।
जनगणना का उद्देश्य भारत की जनसंख्या की पूरी तस्वीर पेश करना है। गिनती में थोड़ी-बहुत कमी भी जनसंख्या से जुड़े अनुमानों की सटीकता को प्रभावित कर सकती है, खासकर उन आबादी के मामले में जो पहले से ही एक जगह से दूसरी जगह आती-जाती रहती है या जिन तक पहुंचना मुश्किल होता है।
डिजिटल जनगणना, डिजिटल जोखिम
जनगणना 2027 को भारत की पहली पूरी तरह से डिजिटल जनगणना के रूप में भी पेश किया जा रहा है, जिसमें ऑनलाइन खुद से गिनती (सेल्फ-एन्यूमरेशन) और डिजिटल टूल्स का इस्तेमाल किया जाएगा। तकनीक राष्ट्रीय स्तर पर गिनती को तेज और संभावित रूप से अधिक कुशल बना सकती है। लेकिन डिजिटलीकरण जोखिमों के स्वरूप को भी बदल देता है।
जितनी अधिक संवेदनशील जानकारी को डिजिटल किया जाता है, डेटा लीक (डेटा ब्रीच) उतना ही गंभीर हो जाता है। ‘इंटरनेट फ्रीडम फाउंडेशन’ ने आधार, वोटर आईडी, पासपोर्ट और मोबाइल नंबरों को जाति, धर्म, भाषा, प्रवास के इतिहास और अन्य जनसांख्यिकीय जानकारी के साथ जोड़ने को लेकर चिंता जताई है। उनका तर्क है कि इन पहचानकर्ताओं (आइडेंटिफायर्स) के जरिए जनगणना की जानकारी को अन्य सरकारी डेटाबेस से जोड़ना संभव हो सकता है। यह चिंता इसलिए भी महत्वपूर्ण है क्योंकि हमलावर के लिए किसी डेटाबेस की अहमियत जरूरी नहीं कि किसी एक खास जानकारी (फील्ड) से ही तय हो। यह जानकारी के अलग-अलग हिस्सों को एक साथ जोड़ने की क्षमता से भी तय हो सकती है।
जाति, धर्म, आर्थिक स्थिति, पारिवारिक संबंध, प्रवास का इतिहास और विशिष्ट पहचानकर्ताओं वाले डेटाबेस से किसी व्यक्ति के बारे में उससे कहीं ज्यादा जानकारी मिल सकती है, जितनी कि इन जानकारियों को अलग-अलग देखने पर मिलती। उदाहरण के लिए, 2023 के CoWIN डेटा लीक से जुड़ी रिपोर्टों ने संवेदनशील निजी जानकारी से जुड़ी कमज़ोरियों के संभावित नतीजों को दिखाया। जनगणना की जानकारी लीक होने के नतीजे पहचान की चोरी से कहीं आगे तक जा सकते हैं। जाति, धर्म और आबादी से जुड़ी संवेदनशील जानकारी का इस्तेमाल भेदभाव, प्रोफ़ाइलिंग, धोखाधड़ी या किसी खास व्यक्ति को परेशान करने के लिए किया जा सकता है।
कानूनी ढांचा खुद बदलाव के दौर से गुज़र रहा है
भारत के डेटा-सुरक्षा सिस्टम के समय को लेकर भी एक समस्या है। इंटरनेट फ्रीडम फाउंडेशन ने बताया है कि ‘डिजिटल पर्सनल डेटा प्रोटेक्शन एक्ट, 2023’ और इसे लागू करने वाला ढांचा, पूरी जनगणना प्रक्रिया के दौरान उस तरह की पूरी सुरक्षा नहीं देता, जैसी किसी बेहतर डेटा-सुरक्षा सिस्टम से उम्मीद की जाती है।
इस संगठन ने खास तौर पर जनगणना कानून की अनिवार्य प्रकृति और नए डेटा-सुरक्षा उपायों के बीच तालमेल पर सवाल उठाए हैं। जनगणना कानून की धारा 8(2) लोगों को नोटिफ़ाई किए गए सवालों के जवाब देने के लिए कानूनी रूप से बाध्य करती है, जबकि धारा 11 में मना करने या बाधा डालने पर सजा का प्रावधान है। इससे सहमति का मामला काफी पेचीदा हो जाता है।
जनगणना और भरोसे का समझौता
असल में, जनगणना भरोसे पर आधारित एक प्रक्रिया है। सरकार नागरिकों से अपने और अपने परिवार के बारे में जानकारी देने के लिए कहती है, इस समझ के साथ कि यह जानकारी आबादी की स्थिति के सामाजिक-आर्थिक संकेतक के तौर पर काम आएगी। यह समझौता तब और कमजोर हो जाता है जब प्रश्नावली में ऐसी जानकारी मांगी जाने लगती है जिससे किसी व्यक्ति को कई मौजूदा डेटाबेस से जोड़ा जा सकता है।
बहुत ज्यादा जानकारी इकट्ठा करने का खतरा सिर्फ इस बात तक सीमित नहीं है कि आज उस डेटाबेस का मकसद क्या है। बड़े डेटाबेस की अहमियत इसलिए बढ़ जाती है क्योंकि उनका इस्तेमाल ऐसे कामों के लिए किया जा सकता है जिनके बारे में जानकारी इकट्ठा करते समय सोचा भी नहीं गया होगा। इसीलिए जिम्मेदार डेटा गवर्नेंस में ‘मकसद की सीमा’ (purpose limitation) और ‘कम से कम डेटा इकट्ठा करना’ (data minimisation) बुनियादी सिद्धांत हैं।
अगर मकसद भारत की आबादी को समझना है, तो सरकार को यह बताना चाहिए कि उस समझ को बनाने के लिए हर अतिरिक्त पहचान-जानकारी क्यों जरूरी है। अगर आधार नंबर से कोई डेमोग्राफिक आंकड़ा नहीं मिलता, तो उसे इकट्ठा करने के लिए अलग से वजह बतानी होगी। अगर पासपोर्ट नंबर से आबादी की गिनती में कोई मदद नहीं मिलती, तो सरकार को बताना होगा कि उसे किस मकसद से रिकॉर्ड किया जा रहा है। अगर किसी सांख्यिकीय काम के लिए माता-पिता के जन्म की सही जगह जानना जरूरी है, तो वह मकसद साफ तौर पर बताया जाना चाहिए। यही नियम मोबाइल नंबर, वोटर आईडी और दूसरी पहचान-जानकारियों पर भी लागू होना चाहिए। डेटाबेस जितना बड़ा होगा, जानकारी की हर अतिरिक्त कैटेगरी के लिए उतनी ही मजबूत वजह होनी चाहिए।
इसलिए, जनगणना 2027 के सामने बुनियादी सवाल सिर्फ यह नहीं है कि सरकार कितनी जानकारी इकट्ठा कर सकती है। सवाल यह है कि किसी तय मकसद के लिए एक लोकतांत्रिक सरकार को कितनी जानकारी इकट्ठा करनी चाहिए, और यह पक्का करने के लिए क्या सुरक्षा उपाय होने चाहिए कि उस जानकारी का बाद में किसी और मकसद के लिए इस्तेमाल न हो। आबादी की जनगणना का मकसद देश को यह बताना होता है कि उसमें कौन रहता है, लोग कैसे रहते हैं, कहां रहते हैं और उनके हालात क्या हैं। इससे नागरिकों के मन में यह सवाल नहीं उठना चाहिए कि क्या उनकी गिनती करने के दौरान सरकार उनके बारे में और भी ज्यादा विस्तृत जानकारी का नक्शा तैयार कर रही है।
Related:
Ensure transparency and inclusion in the 2027 Census: CCG
To count or not to count, delays and India’s decadal Census
Caste Census Survey Result: 63% OBCs, 19% SCs and 1.68% STs constitute Bihar’s total population
The Whys behind a caste-based census point to an urgent imperative